
「チームの休暇申請を管理する、小さなWebアプリを作って」。AIにこう頼んだら、最初の数分は順調だったのに、作業が長くなるにつれて方針がずれていった。「できました」と言われたのに、テストが通っていなかった。そんな経験はありませんか。
Superpowersは、コーディングAIに開発の段取りを持たせるプラグインです。中身は15個のSkillと、会話の始めに案内役のSkillを読み込ませる仕組みです。作りたいものを伝えると、AIはすぐにはコードを書かず、目的を確かめて設計書を作り、承認を得てから計画書を書きます。実装はテストを先に書きながら1つずつ進め、終わったら実行結果で確かめ、最後に「どう統合するか」を人に選んでもらいます。
人が確かめるのは、主に始めと終わりです。途中でAIが決めたことは記録され、最後にまとめて報告されます。
この記事では、2026年10月11日に編集部が実際に休暇申請アプリを頼んだ結果を使って、頼み方、人が確かめる場面、手元に残るファイル、注意点を順に紹介します。試験では、プラグインをこのプロジェクトだけに入れ、ユーザー単位の設定・プラグインとMCP(外部ツールへの接続)を読み込まない新しいClaude Codeの会話で動かしました。後半では、Skillを作る人に向けて、15個のSkillを一本の流れにつなぐ設計を読み解きます。
こんなふうに、開発を頼める
依頼は、たとえば次のように書きます。編集部はこの3行を1行にまとめて、そのまま送りました。
チームの休暇申請を管理する小さなWebアプリを作りたいです。
申請者が日付と理由を入力し、上長が承認または却下できれば十分です。
まず設計から始めて、実装に入る前に設計書を確認させてください。
送ったあと、AIはコードを書く前にbrainstorming Skillを呼び出し、依頼の重さを分類して宣言しました。最初の応答の冒頭は次のとおりです。
進め方: リポジトリは空(README と plugin 設定のみ)で、新規プロジェクトにあたります。そのため アーキテクチャ設計パス で進めます。質問 → アプローチ比較 → 設計の提示 → 設計書(
docs/superpowers/specs/)の作成とコミット → ご確認 → 実装計画、の順です。実装は設計書を確認していただくまで始めません。
編集部がClaude Code(v2.1.296、Opus 5.5)で実行したときの応答の抜粋(2026年10月11日、権限モードacceptEdits)。Superpowersは公式マーケットプレイスから入ったv6.4.1。
続けてAIは、依頼から読み取ったことと推測したことを分けて書き出し、「このアプリは、主にどのように使う予定ですか?」と、目的を1問だけ聞いてきました。ここからの流れで、人が確かめた場面は次の4つです。
1. 質問に答え、設計書を承認する。 編集部は「まずはプロトタイプ。10人程度のチームで使い、Node.jsとExpressで作る。データはJSONファイルで十分。ログインは不要で名前を入力するだけ。テストはnpm testで実行する」と答えました。AIは次に、ログインがない場合に上長をどう区別するかを、おすすめ付きの3択で聞いてきました。そのあと、作り方を3案(サーバーでHTMLを作る案をおすすめ)示し、設計を「構成とデータモデル」「画面・ルートとエラー処理」「テスト方針」の3回に分けて見せ、そのつど確認を取りました。合意すると、設計書を書いてgitにcommitし、「会話で合意した内容に、私の判断で書き加えた点」(IDの振り方、エラーの種類、ポート番号など7点)を挙げて承認を求めました。依頼から設計書の承認まで、約3分でした。
2. 計画書を確かめ、進め方を選ぶ。 承認すると、AIはwriting-plans Skillで計画書を作り、commitしました(約4分半)。計画は3つのタスクで、各タスクにテストのコードと実装のコードがすべて書かれていました。設計書にない注意点(ボタンの連打、壊れたデータファイル、<script>を含む入力など5項目)も、テスト付きで足されていました。そのうえで、タスクごとに別のAIへ任せる「Subagent-driven」と、同じAIが続けて実装する「Native」のどちらで進めるかを聞かれ、AIは「タスクは3つだけ」などを理由にNativeをすすめました。編集部はNativeを選びました。
3. 作業場所を分けるかに答えたら、あとは待つ。 Nativeを選ぶと、AIは実装の前に「分離した worktree を作って、そこで実装しますか?」と聞いてきました(worktreeは、同じリポジトリの別の作業フォルダ)。「はい」と答えたあとは、実装の終わりまで、AIから質問は一度もありませんでした。この間にAIは依存関係をインストールし、3つのタスクを「失敗するテストを書く→実装して通す→commit」の順で進め、進み具合を台帳ファイルに書いていきました。
4. 判断の一覧を読み、統合方法を選ぶ。 3つのタスクが終わると、AIは新しい文脈のレビュー担当(別のAI)にブランチ全体を確認させました。指摘は重大0件、重要0件、軽微6件で、AIは軽微のうち1件(理由欄の改行を2文字と数え、上限近くの入力が弾かれる)を重要に引き上げ、失敗するテストを先に書いてから直しました。最後のメッセージには、途中で自分が決めたことが「私が判断して決めたこと」という見出しで並び、次の選択肢が出て止まりました。
このブランチをどうしますか?
1. main にローカルでマージする
2. push して Pull Request を作成する(このリポジトリにはまだリモートが設定されていません)
3. ブランチをこのまま残す(後で自分で対応する)
編集部の試験で表示された画面のテキスト(2026年10月11日、Claude Code v2.1.296、Opus 5.5、権限モードacceptEdits、Superpowers v6.4.1)。Skillの原文では英語の決まった文面(Implementation complete. What would you like to do?)が指定されているが、日本語の会話では日本語に訳して表示された。
編集部は「3」を選んで終えました。送信時、編集部の操作ミスで先頭に余分な「11」が入り「113. ブランチをこのまま残してください。」となりましたが、AIは「「113」は 3 番の意味と受け取りました。違っていればお知らせください。」と断ってから、ブランチを残して終えました。依頼を送ってからこの選択肢が出るまで、約22分でした。
会話の記録は編集部で保存しています。依頼文と、AIの質問・確認への返答以外の補足は送っていません。
できあがったアプリ
実装はブランチworktree-leave-appに残り、テストは45件すべて通っていました。編集部がそのブランチでアプリを起動し、ブラウザで操作した画面です。
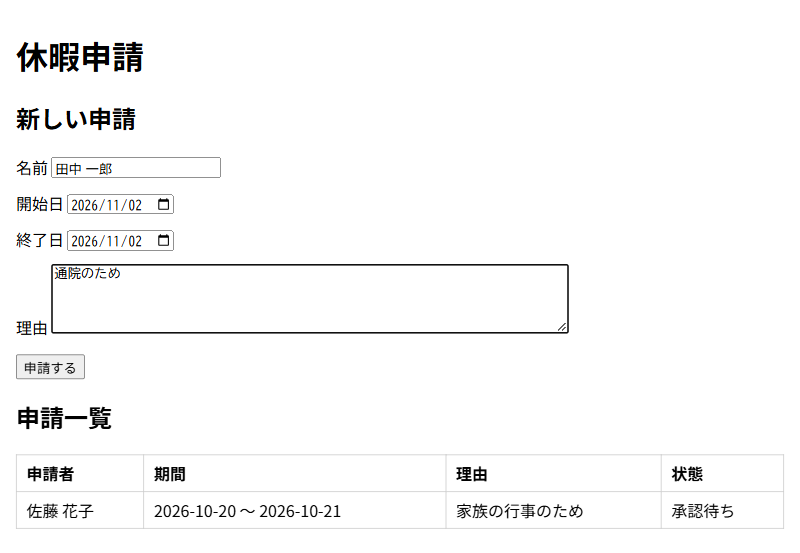
申請者の画面(/)。2件目の申請を入力したところ。架空の名前を使用。
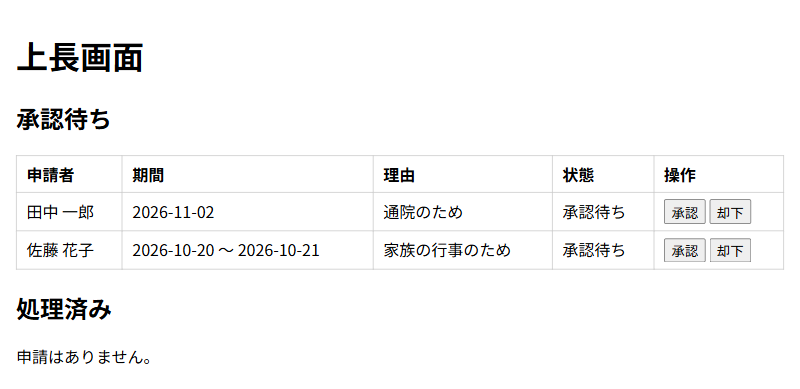
上長の画面(/manager)。承認待ちの申請に「承認」「却下」のボタンが付く。ログインはなく、URLを知っていれば誰でも開ける設計(合意した設計どおり)。
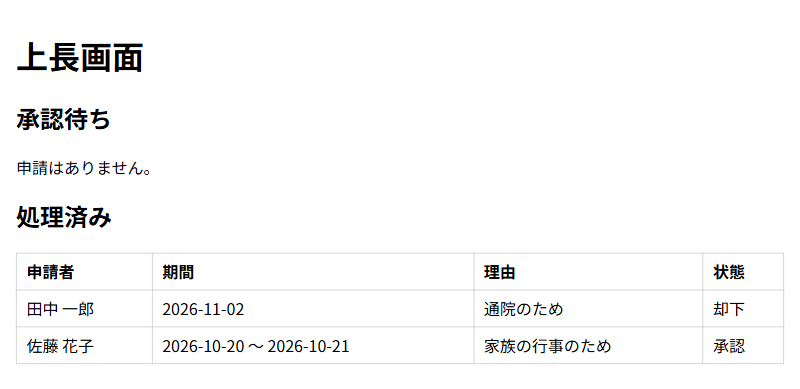
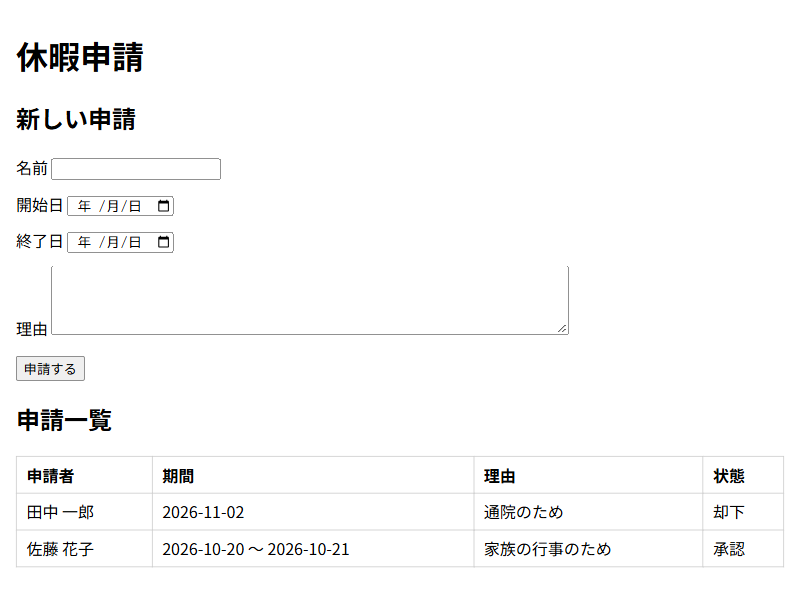
1件を承認、1件を却下したあとの上長の画面と申請者の画面。いずれも2026年10月11日、編集部がSuperpowersで作ったアプリを起動して撮影(幅800ピクセルのブラウザ)。
手元に残ったファイルは、主に次の2つです。
- 設計書:
docs/superpowers/specs/2026-10-11-leave-app-design.md(214行)。目的、成功の基準、作らないもの、構成、データ、画面、エラー処理、テスト方針。gitにcommitされた - 計画書:
docs/superpowers/plans/2026-10-11-leave-app.md(1,210行)。3つのタスクの手順と、テスト・実装のコード全文。gitにcommitされた
途中の進み具合を書く台帳(.superpowers/sdd/2026-10-11-leave-app/progress.md)は、実装中に作られ、最終レビューが終わったあとには削除されていました(フォルダには.gitignoreだけが残っていました)。
なお、原文は、依頼が軽ければ流れも軽くするよう指示しています。既存のコードに範囲のはっきりした変更を加える「Bounded」なら、チャット上の短い設計に承認をもらってから計画書を作らずに実装し、実現できるかを試す「Spike」なら、調べた結果の報告で終える、という指示です。今回の試験では、この2つの経路は試していません。
便利なのは、半日以上かかる開発
AIに「まず計画を立てて」「テストを先に書いて」「終わったらテストを実行して」と頼むこと自体は、Skillがなくてもできます。
Superpowersを入れると変わるのは、こうした段取りを毎回の依頼で指示しなくてよくなる点です。どの順で進めるか、次にどのSkillへ引き継ぐか、途中で何を記録するか、いつ止まるか、何をもって完了とするか。これらが15個のSkillに書かれていて、会話の始めに案内役のSkillが自動で読み込まれ、そこから工程ごとのSkillが順に呼ばれます(今回の試験でも、依頼文でSuperpowersに触れずにこの流れになりました)。
そのため、効果が大きいのは、作業が長く、途中で方針がずれやすい仕事です。
- 新しい機能や小さなアプリを、設計から作る
- 既存のコードの構造を変えるような、影響範囲の広い変更
- 原因の分からない不具合の調査(原因を突き止める前に修正させないSkillがある)
一方で、向かない場面もあります。原文は、既存のコードへの小さな変更でも「Bounded」として短い設計を見せ、承認を得てから実装するよう指示しています。1行の修正のような作業では、この手続きが重く感じられる可能性があります(編集部はBoundedの経路を試していません)。今回の小さなアプリでも、設計書を承認するまでに7回答え、完成まで約22分かかりました。また、Superpowersはソフトウェア開発のために作られており、そのまま開発以外の業務に使うものではありません。
導入して、同じ例を試す
導入の前に知っておくこと
手元の環境に変更を加えます。 編集部の試験では、会話の開始時にプラグインのスクリプトが動き、案内役のSkillが読み込まれました。実装に入ると、AIはリポジトリの中(.claude/worktrees/leave-app)に別の作業フォルダとブランチを作り、npm installで依存関係を入れ、タスクごとにcommitしました。最初は試験用のリポジトリで動かします。
コマンドの実行確認が何度も出ます。 権限モードacceptEditsはファイルの編集だけを自動で許可するため、git commit、npm install、npm test、動作確認のサーバー起動などは、そのつど許可を求められました。今回の試験では約50回で、そのうち10回は最終レビューを担当した別のAIからの確認でした。編集部は内容を読み、試験用フォルダの中で完結するものだけを許可しました。
費用がかさむ進め方があります。 タスクごとに別のAIへ実装とレビューを任せる方式について、原文自身が「最も丁寧だが、タスクごとに新しい文脈の費用がかかる」と説明しています。1件あたりの費用の上限は書かれていません。今回選んだ安い方式(同じAIが続けて実装し、最後に1回だけ別のAIがレビュー)でも、会話の記録によると、出力が約9万トークン、過去の文脈の再読み込みを含む入力が約720万トークンでした。規模の大きな依頼の前に、使えるAIの利用枠を確かめておきます。
使用状況を作者側へ知らせる仕組みがあります。 READMEによると、設計時に図や画面案を見せる補助ツール(Visual Companion)は、ロゴ画像を作者のWebサイトから読み込み、その際に使っているSuperpowersのバージョンが送られます。プロジェクトの内容は含まれないと説明されており、環境変数SUPERPOWERS_DISABLE_TELEMETRYで止められます。今回の試験では、このツールは使われませんでした。
組織のルールは、指示ファイルに書けます。 原文は、利用者の指示(CLAUDE.mdやAGENTS.mdなど)がSkillより優先されると明記しています。「顧客データに触れる操作の前は必ず止まる」といった自社のルールは、そちらに書きます。
プラグイン自体はMITライセンスのOSSですが、AIサービスの利用料は別にかかります。セキュリティの自動監査はSkillごとに表示されるため、入れるSkillのページをそれぞれ確認してください。
インストールする
READMEは、Claude Codeの会話の中で/plugin install superpowers@claude-plugins-officialと打って公式マーケットプレイスから入れる方法を載せています。編集部は、ほかのプロジェクトの会話にフックが及ばないよう、試すリポジトリのフォルダで次のコマンドを実行し、そのプロジェクトだけに入れました。
claude plugin install superpowers@claude-plugins-official --scope project
実行すると、そのフォルダの.claude/settings.jsonに有効化の記録("superpowers@claude-plugins-official": true)が書き込まれ、ユーザー全体の設定ファイル(~/.claude/settings.json)は変わりませんでした。プラグイン本体は、ユーザー単位のキャッシュ(~/.claude/plugins/cache/)に置かれます。2026年10月11日の時点で入ったのは、GitHubの最新リリース(v6.4.2)ではなく、v6.4.1でした。試し終わったら、同じフォルダで次のコマンドを実行すると外せます。
claude plugin uninstall superpowers@claude-plugins-official --scope project
ほかのAIツール向けの手順は、READMEに導入先ごとに載っています。
導入後は、そのフォルダで新しい会話を始めます。編集部の試験では、冒頭の依頼を送った直後に、AIがコードを書く前にbrainstorming Skillを呼び出し、分類を宣言して質問を始めました。これが、正しく入っていることの確かめ方になります。AIが「入っています」と答えただけでは、導入できた証拠になりません。READMEにあるLet's make a react todo listという確認方法は、今回は試していません。
依頼して、受け取る
冒頭の依頼文を送り、質問に答えます。設計書と計画書は、承認する前に必ず自分で読みます。ここで合意した内容が、そのあとの実装の基準になるからです。今回の設計書は214行、計画書は1,210行ありました。
実行中と、終わったあと
原文は、実行中のAIが止まって人に聞いてよいのを、次の4つの場合と、すべてのタスクが終わったときだけに限っています。
- 取り消せない操作や、壊してしまう可能性のある操作
- セキュリティに関わる操作
- マージや共有ブランチへのpushなど、作業フォルダの外に影響する操作
- どの進め方を選んでも当て推量になるほど、計画が壊れているとき
編集部の試験では、実装中にAIが人に質問したことは一度もありませんでした。ただし、実装に入る直前に、作業フォルダ(worktree)を分けるかどうかを1回聞いてきました。これは4つの場合ではなく、using-git-worktrees Skillの「利用者の希望が分からなければ、作る前に同意を得る」という指示によるものです。また、前の節で書いたClaude Code自体のコマンド実行の確認は、この4つとは別に出ます。
それ以外の食い違いや曖昧さは、AIが自分で判断して進みます。原文は、判断を「何を決めたか — なぜか — 間違っていたら何を失うか」の形で台帳に書き、最後のメッセージの「Rulings I made」に決めた順にすべて並べるよう指示しています。今回の台帳には、次の1行が書かれていました。
Task 3: Ruling: plan Step 7 smoke command sends Japanese via curl --data-urlencode, which Windows curl encodes as Shift_JIS (stored as raw %8A... text) — re-ran with pre-encoded UTF-8 bytes; browsers submit UTF-8 because pages declare charset=utf-8, so app code unchanged — cost if wrong: non-UTF-8 clients would store mojibake-like raw text
作業中の台帳(progress.md)の1行。2026年10月11日、編集部の試験で、最終レビューの前に保存したもの。
計画書にあった動作確認のコマンドが、Windowsでは日本語を正しく送れなかったため、確かめ方を変えた、という判断です。最後のメッセージでは、この判断が「私が判断して決めたこと」の見出しの下に日本語で書かれ、レビューの指摘のうち直さないと決めたもの7件と、見送った軽微な指摘6件も並んでいました。
作業を捨てる選択について、原文は、利用者がはっきり求めたときだけ示し、discardと入力して初めて実行するよう指示しています。今回は捨てる操作を試していません。
自動ではやらないこと
途中の判断を記録した台帳は、最終レビューが終わると削除されます(今回の試験でも削除されていました)。原文は、判断の一覧を最後のメッセージに載せることを「判断が利用者に届く唯一の場所」としています。つまり、会話の記録を消せば、判断の一覧も手元から消えます。
そのため、終わったら次の手順を自分で回します。
- 最後のメッセージの判断の一覧を読み、「間違っていたら何を失うか」が大きいものから確かめる
- 判断の一覧を、プルリクエストの説明や課題管理のツールなど、会話の外に保存する
- 誤っていた判断があれば、その部分の修正を新しい依頼として頼む
- 統合方法を選び、結果(マージされたか、プルリクエストができたか)を確かめる
「ブランチをこのまま残す」を選んだ場合、作業フォルダとブランチは残り、mainには何も入りません。今回、AIは「あとで main にマージするときは、元のリポジトリで git merge worktree-leave-app を実行してください。」と案内して終えました。
使う前・統合する前に見るのは3点
1. 設計書と計画書を、自分で読んだか。 Superpowersの承認は、人が読んで同意したことを前提にしています。原文の指示どおりなら、承認したあとは途中で質問せずに最後まで進みます。今回も、計画書を承認してからは、作業フォルダの確認を除いて質問はありませんでした。
2. 判断の一覧を確かめたか。 実行中にAIが決めたことは、途中では知らされません。今回の一覧には、認証がないためCSRF対策(なりすましの送信を防ぐ仕組み)をしない、という判断も含まれていました。プロトタイプなら妥当でも、本番で使うなら見過ごせない判断です。一覧の「間違っていたら何を失うか」を見て、影響の大きいものから確かめます。
3. 入った版のSKILL.mdを根拠にしているか。 GitHubの最新リリース(v6.4.2)のwriting-plans SKILL.mdは、実装の手順を関数の形とテストで示し、コードブロックはそれだけでは決まらない処理にだけ使うよう書いています。コードが計画の大半を占める場合は、本体を関数の形・テスト名・確かめる内容に置き換えるよう指示しています。一方、2026年10月11日に公式マーケットプレイスから入ったv6.4.1の同じSKILL.mdは「コードの手順にはコードブロックが必須」としており、実際にできた計画書(1,210行)には、テストと実装のコードがすべて書かれていました。READMEの「各タスクに完全なコードを含める」という説明は、v6.4.1の動きのほうに近いものでした。更新の速いプラグインなので、細かな動きは、手元に入った版(~/.claude/plugins/cache/の中のSKILL.md)で確かめます。
このプラグインは、AIへの仕事の教え方をどう組み立てているか
ここからは、自分でSkillを書く人に向けた内容です。
前半では、休暇申請アプリを、設計の合意から統合方法の選択まで進める流れを見ました。後半では、15個のSkillを一本の流れとして動かしている書き方を読み解きます。
Superpowersの特徴は、個々のSkillを賢くするより、Skillがどう呼ばれ、次にどこへ引き継ぎ、何をファイルに残し、いつ止まり、何をもって完了とするかを書き分けていることです。それぞれを、同じ休暇申請アプリの例に当てはめて見ていきます。
全体の構造
リポジトリの主な部分と、利用者の手元にできるファイルの役割は次のとおりです。
hooks/                 … 会話の開始時・クリア時・圧縮後に、案内役のSkillを読み込ませる
skills/(15個)         … 設計、計画、実装、レビュー、検証、統合など、工程ごとのSkill
skills/ の同梱ファイル   … 実装担当・レビュー担当への依頼文の型、作業記録用のスクリプト
docs/superpowers/specs/ … 設計書(利用者のリポジトリにcommitされる)
docs/superpowers/plans/ … 計画書
.superpowers/sdd/       … 作業中の台帳と依頼書(最終レビュー後に削除)
.claude-plugin/ など    … 各AIツール向けのプラグイン定義
新規開発の流れを一行にすると、次のとおりです(Skillの受け渡し指示から編集部が組み立てたもの)。
会話の開始時に
using-superpowersを読み込む →brainstormingで分類・設計・設計書の承認 →writing-plansで計画書と進め方の選択 →using-git-worktreesで作業場所を隔離 →subagent-driven-developmentまたはexecuting-plansで、タスクごとにテスト先行で実装・レビュー・台帳記録 →verification-before-completionで証拠を確認 →finishing-a-development-branchで判断の一覧と統合方法の選択
設計書と計画書はリポジトリに残ります。作業中の状態は台帳で管理しますが、台帳は作業が終わると削除されます。
編集部の試験(同じAIが続けて実装する方式)で、Skillとして呼ばれた順は次のとおりでした。using-superpowersは呼び出しではなく、会話の開始時にフックで読み込まれていました。
brainstorming→writing-plans→executing-plans→using-git-worktrees→test-driven-development→finishing-a-development-branch
verification-before-completionは、今回はSkillとしては呼ばれませんでした。テストの実行結果を確かめる手順は、executing-plansの指示の中で行われていました。
以下の5つの解説は、いずれも「原文の書き方 → 休暇申請アプリの例でどう働くか → 省いたら起こりうること → 自分のSkillへの応用」の順で書きます。「省いたら起こりうること」は設計上の推論で、比べて試した結果ではありません。「応用する指示の例」は編集部の提案で、原文の引用ではありません。
1. 入口のSkillを、会話の始めに必ず読み込ませる
原文の書き方(hooks/hooks.json、using-superpowers、各Skillのdescription)
Claude Code用のフック設定は、会話の開始時、クリア時、文脈の圧縮時(startup|clear|compact)にスクリプトを動かし、using-superpowersの全文をAIに読み込ませます。using-superpowersには「Skillが当てはまる可能性が1%でもあれば、必ず呼び出す」と強い言葉で書かれています。
あわせて、15個のSkillのdescriptionは「Use when…(〜のときに使う)」で始まる、呼ぶ場面だけを書いています。writing-skillsによると、descriptionに手順の要約を書いたところ、AIが本文を読まずに要約どおりに動いてしまったという検証結果があったためです。
休暇申請アプリの例でどう働くか
編集部の試験では、会話の記録に、開始時のフックがusing-superpowersの全文を読み込ませた記録が残っていました。依頼文には「Superpowers」という言葉を入れていませんが、AIは最初の操作としてbrainstormingを呼び出し、分類を宣言してから質問を始めました。今回の約22分の会話では文脈の圧縮が起きなかったため、圧縮時の読み込み直しは確かめていません。
省いたら起こりうること
Skillを入れておくだけでは、AIが呼ぶかどうかは状況次第です。呼ばれなければ、段取りは最初から働きません。
応用する指示の例
description: 社内向けの資料を作る、または直すときに使う。
(本文の先頭)作業を始める前に、当てはまる手順のSkillがないか確かめ、あれば先に読む。
descriptionには「いつ使うか」だけを書き、何をするかの要約は本文に置きます。複数のSkillを組み合わせる場合は、どれを呼ぶべきかを判断させる案内役のSkillを用意し、確実に読み込まれる場所(会話の始めに読まれる指示ファイルなど)から参照させます。
2. 次に引き継ぐSkillを「必須」と書き、呼んではいけない先も書く
原文の書き方(各Skillの受け渡し指示)
各SKILL.mdには、**REQUIRED SUB-SKILL:** Use superpowers:test-driven-developmentのように、次に必ず使うSkillが印付きで書かれています。brainstormingの新規開発の経路では、終わったあとに呼んでよいのはwriting-plansだけで、ほかの実装用のSkillは呼ばないよう明記しています。writing-skillsは、ファイルを@で直接読み込ませる書き方は、必要になる前に大量の文脈を使うので避けるべきだとしています。
休暇申請アプリの例でどう働くか
編集部の試験では、設計書を承認すると、AIは「実装計画を作成するため、writing-plansスキルを使います。」と書いてwriting-plansを呼び、計画書と進め方の選択に進みました。実装用のSkill(executing-plans)が呼ばれたのは、計画書を承認し、進め方を選んだあとでした。1回の試験なので、どんな依頼でも計画を飛ばさないとまでは言えません。
省いたら起こりうること
次に何を呼ぶかが書かれていないと、使えるSkillが多いほど、AIは手近なものを選びます。設計の直後に実装用のSkillへ進み、計画が抜け落ちる可能性があります。
応用する指示の例
この手順が終わったら、必ず「proofreading」Skillを使う。
このSkillの後に「publishing」Skillを直接呼んではいけない。
Skillを部品として並べるだけでなく、「次はこれ」「これは飛ばさない」をそれぞれのSkillの中に書きます。読み込みは、必要になった時点で名前を挙げて呼ぶ形にします。
3. 会話ではなく、ファイルで渡す
原文の書き方(subagent-driven-development、executing-plans)
タスクを実装する別のAIには、会話の履歴ではなく、タスクの依頼書ファイルの場所と、前のタスクから引き継ぐ関数名などだけを渡します。原文には、過去のタスクの要約を依頼文に貼り続けた結果、依頼文42,000文字の99%が履歴になっていた実例が載っています。進み具合は台帳ファイルに書き、文脈が圧縮されたあとは自分の記憶より台帳とgitの履歴を信じる、と定めています。台帳の1行目には対象の計画書名が書かれ、別の計画の台帳を読み違えないようにしています。
休暇申請アプリの例でどう働くか
今回は同じAIが続けて実装する方式を選んだため、タスクを別のAIに渡す場面はありませんでした。それでも、作業用のフォルダには台帳(progress.md)とタスクごとの依頼書(task-1-brief.md〜task-3-brief.md)が作られ、台帳の1行目には# SDD ledger — plan: docs/superpowers/plans/2026-10-11-leave-app.mdと対象の計画書が書かれていました。各タスクが終わるたびに、Task 1: complete (commits 2bafd51..ca6ccb5, tests: npm test → ℹ duration_ms 147.7245)のように、commitの範囲とテストの結果が1行ずつ追記されていました。最終レビューの担当には、会話の履歴ではなく、ブランチの差分をまとめたファイルが渡されていました。会話の圧縮は起きなかったので、台帳から再開する場面は確かめていません。
省いたら起こりうること
原文は、会話の記憶が圧縮で失われ、終わったタスクを丸ごと実行し直したことを、観察された中で最も高くつく失敗として挙げています。
応用する指示の例
作業を分けて任せるときは、会話の履歴ではなく、依頼書ファイルの場所と必要な情報だけを渡す。
進み具合は progress.md に書き、再開するときは記憶ではなくこのファイルを読む。
長い作業を扱うSkillでは、「何を・どのファイルで渡すか」と「どこに進み具合を書くか」を決めます。ただし、Superpowersの台帳は作業後に消えます。日をまたぐ業務や引き継ぎに使うなら、残すべき記録を別の場所に移す手順も書きます。
4. 止まる条件を限り、途中の判断は記録して最後に見せる
原文の書き方(subagent-driven-development、executing-plans)
「タスクの間に人へ確認しない。止まってよい理由は、名前を挙げた4つと、すべてのタスクの完了だけ」と書いています。4つ以外の食い違いや曖昧さは自分で判断し、Ruling: <決めたこと> — <理由> — <間違っていたら何を失うか>の形で台帳に記録して進みます。最後には台帳の判断をすべて集め、「Rulings I made」として決めた順に並べ、利用者に見せます。
休暇申請アプリの例でどう働くか
編集部の試験では、計画書にある動作確認のコマンドが、Windowsでは日本語を正しく送れないことが分かりました。AIは止まって聞かずに確かめ方を変え、その判断をRuling:の1行で台帳に書いて進みました(前半で引用した行です)。最後のメッセージでは、この判断が、レビューの指摘を直さないと決めたものと一緒に「私が判断して決めたこと」として並びました。原文の見出しは英語の「Rulings I made」ですが、日本語の会話では日本語の見出しで表示されました。
省いたら起こりうること
止まる条件がなければ、AIは「続けますか?」と聞き続けて人の時間を使うか、何でも黙って決めて進むかのどちらかに寄ります。判断を記録しなければ、黙って決めたことは誰にも見えません。
応用する指示の例
次の場合だけ止まって確認する:取り消せない操作、外部への送信、支払い、個人情報の変更。
それ以外の判断は自分で決め、「決めたこと — 理由 — 間違っていた場合の影響」を記録して進む。
最後に、記録した判断をすべて一覧にして報告する。
止まる条件は、業務のリスクに合わせて書き換えます。開発では作業フォルダの中の変更は元に戻せますが、お金や顧客への連絡が絡む業務では、止まる条件を増やす必要があります。
5. 作る人と確かめる人を分け、完了は証拠で決める
原文の書き方(subagent-driven-development、verification-before-completion)
タスクごとに方式を選ぶ進め方では、実装担当とレビュー担当を別のAIにし、実装担当が自分でレビュアーを呼ぶことを禁じています。同じAIで続ける方式でも、最後に新しいレビュアーを1回呼ぶことを最低条件にしています。レビューの指摘を直す往復は1タスクあたり最大5回で、4回目からは、より能力の高いモデルの新しい担当に替えます。
実装担当の報告は、DONE(完了)、DONE_WITH_CONCERNS(懸念つき完了)、NEEDS_CONTEXT(情報不足)、BLOCKED(進めない)のどれかに決められ、それぞれに指揮役の次の行動が書かれています。verification-before-completionは、「テストが通った」と言うには失敗0件の出力、「担当のAIが完了した」と言うにはgitの差分、のように、主張ごとに必要な証拠を対応表にしています。
休暇申請アプリの例でどう働くか
今回は同じAIが続けて実装する方式だったため、タスクごとのレビューやDONEなどの報告は出てきませんでした。その代わり、3つのタスクが終わると、AIは新しい文脈の別のAI(Opus)にブランチ全体のレビューを任せました。このレビュー担当は、コードを読むだけでなく、大量の同時送信や壊れたデータファイルなどを実際に試し、重大0件・重要0件・軽微6件と判定しました。実装したAIは、軽微の1件を重要に引き上げ、失敗するテストを先に書いて確かめてから直し、45件のテストが通ったことを示して報告しました。編集部も、終わったあとに同じテストを実行し、45件すべて通ることを確かめています。
省いたら起こりうること
作った本人の確認には、同じ見落としが残ります。「完了しました」という報告をそのまま信じると、冒頭で挙げた「できたと言われたのに、テストが通っていない」状態になります。
応用する指示の例
作成とレビューは別の担当で行い、作成担当は自分の成果物をレビューしない。
「完了」と報告するときは、確かめた手順と結果(実行したコマンドと出力など)を添える。
報告は「完了/懸念つき完了/情報不足/進めない」のどれかで始める。
完了を言葉ではなく証拠で判断するよう、主張と証拠の組み合わせを書いておきます。報告の種類を決めておくと、受け取った側の次の行動も決めやすくなります。
各指示の原文は、skillsフォルダとhooksフォルダで確認できます。個々のSkillの書き方をさらに学びたい場合は、Skillをテスト先行で作る手順をまとめたwriting-skillsが参考になります。
補足:プラグインの基本情報
- 名前:Superpowers(Skills.sh)
- 作者・リポジトリ:Jesse Vincent(obra)とPrime Radiant(obra/superpowers)
- 確認したバージョン:原文はv6.4.2(2026年9月25日リリース)を読んで確認。2026年10月11日に公式マーケットプレイス(
claude-plugins-official)から入れて試した版はv6.4.1 - 構成:15個のSkill、会話の開始時に案内役のSkillを読み込ませるフック、各AIツール向けのプラグイン定義
- 対応ツール:READMEには、Claude Code、Codex、Cursor、Gemini CLI、GitHub Copilot CLIなど16の導入先ごとの手順がある
- ライセンス・料金:MIT。AIサービスの利用料は別途。READMEには企業向けの有償サポートの問い合わせ先もある
- 注目度(2026年10月9日確認):Skills.shのインストール数は15個のSkillの合計で3.4M(最多は
brainstormingの385.1K)。GitHub Stars 296.5K(Skills.sh表示。リポジトリ全体の数字) - セキュリティの自動監査:Skillごとに表示される。2026年10月9日に確認した
brainstormingは、Gen Agent Trust HubとSnykがPass、SocketがWarn。自動監査の表示で、安全性を保証するものではない
情報源・参考リンク
